機器的眼睛越看越清,
數據卻多到電腦吞不下
香港理工大學柴楊團隊論文於 2026 年 10 月 20 日刊於 Nature Sensors:增強視覺感測器以約 30 fps 週期保存高保真空間語義,並以事件驅動補上約 10 μs 級暫態。示範 34×34 陣列使感知數據量減少逾 96%,資訊熵約 7.08,高階推理準確率逾 90%。
最後更新:2026 年 10 月 28 日.第 1.1 版
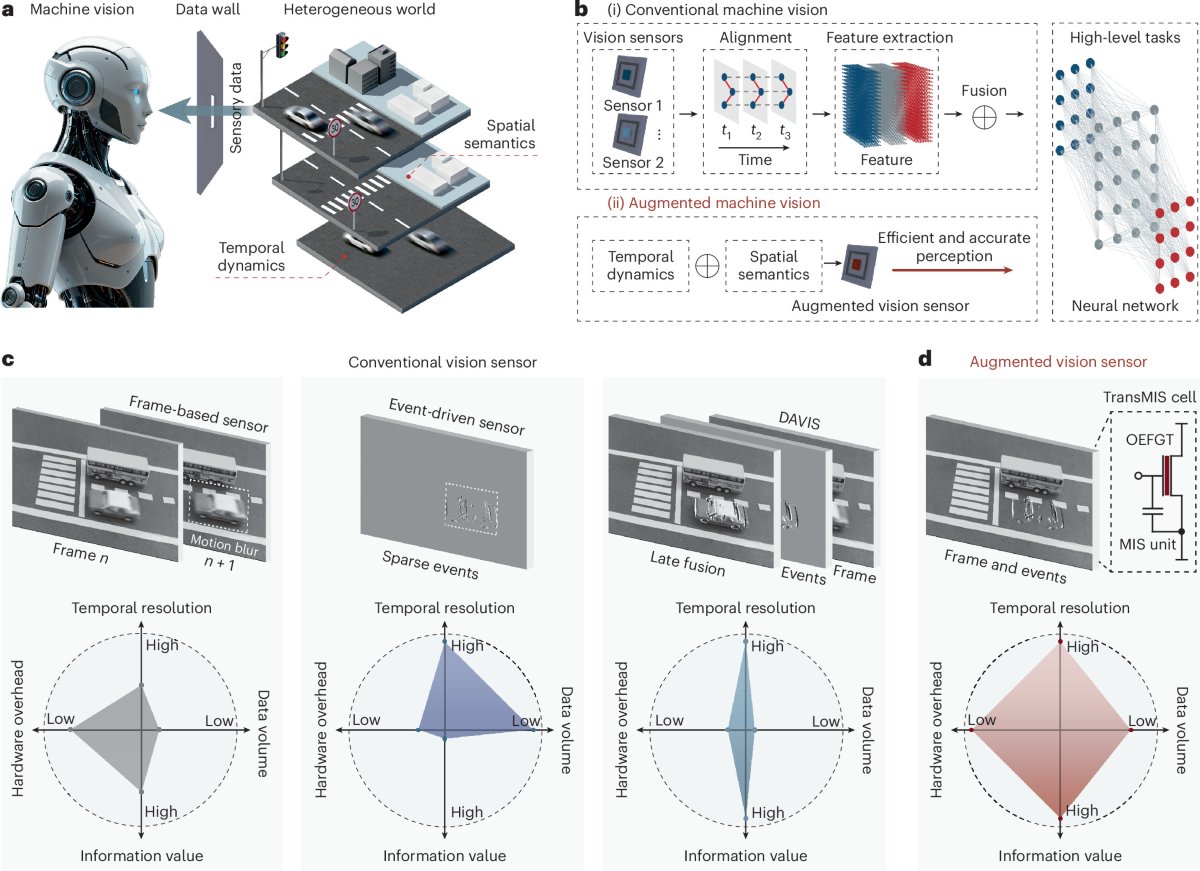
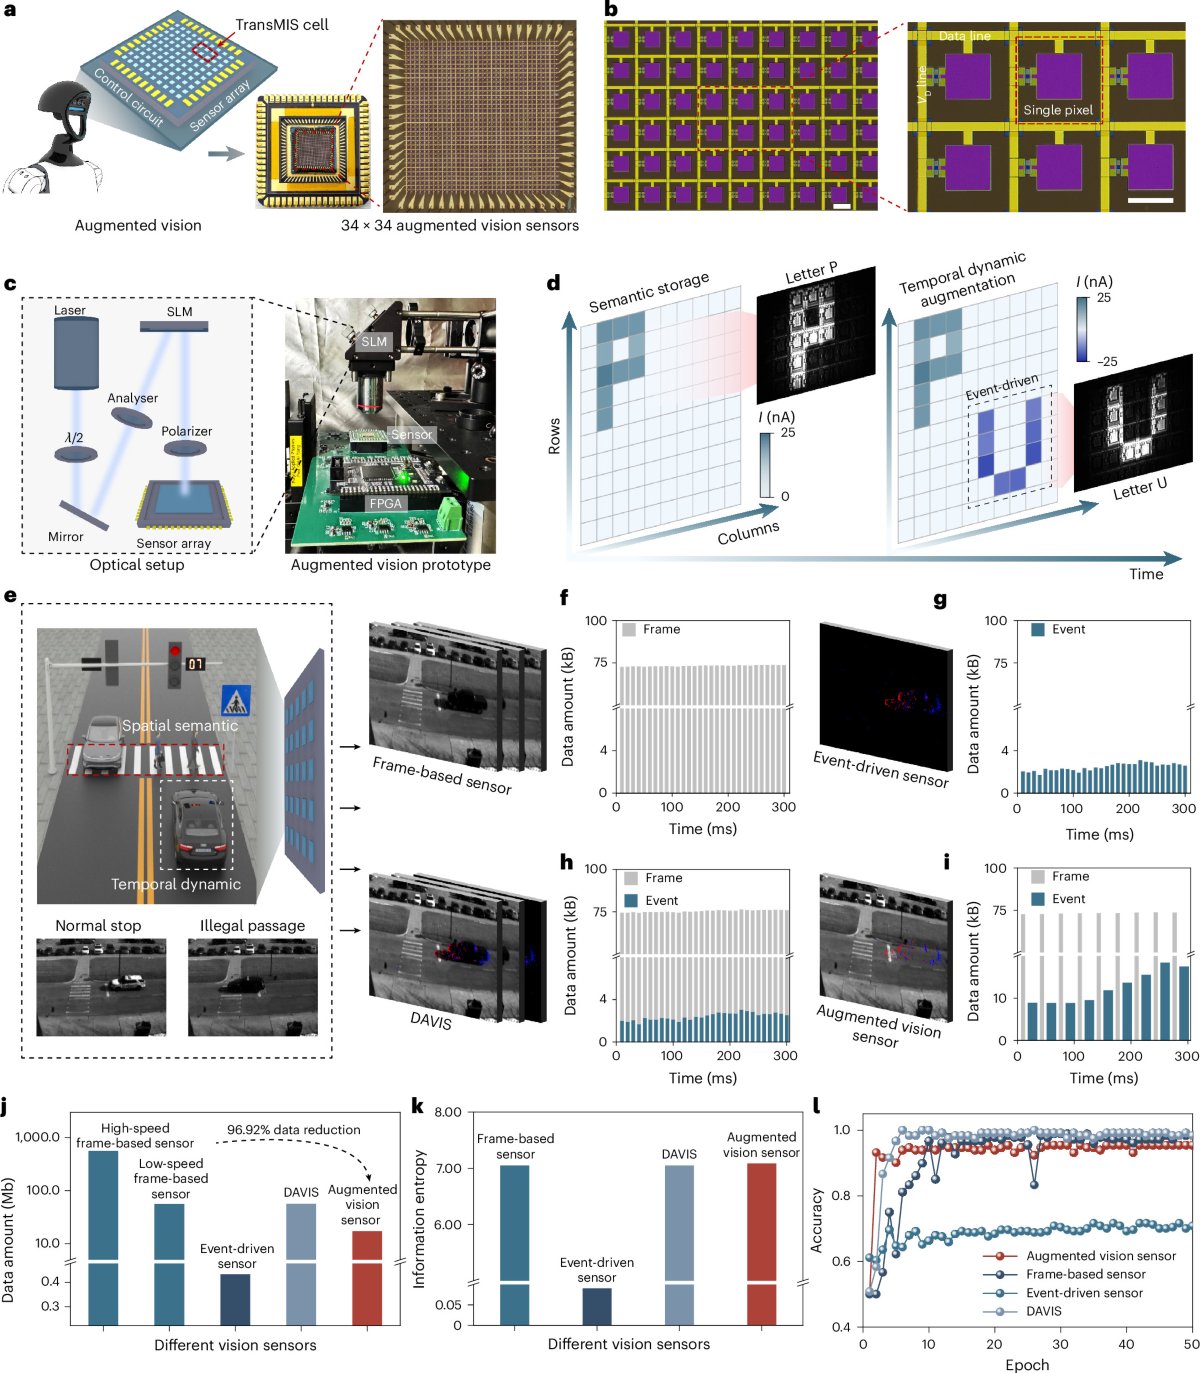
可靠的機器感知往往同時要兩樣東西:足夠細的空間細節辨認物件,以及夠高的時間解像追蹤運動。兩者疊在一起,資料量容易把後端算力壓垮——論文稱之為 data-wall。2026 年 10 月 20 日,香港理工大學物理與材料學系/人工智能物聯網研究院/微電子聯合研究中心團隊在 *Nature Sensors* 發表「增強視覺感測器」(augmented vision sensors)。通訊作者為 柴楊(Yang Chai),第一作者為 任欽麒(Qinqi Ren)等。
論點很明確:與其把異質視覺資訊全丟給後端,不如在感測器前端先抽取。
約 30 fps 留底,事件補上微秒級變化|DESIGN
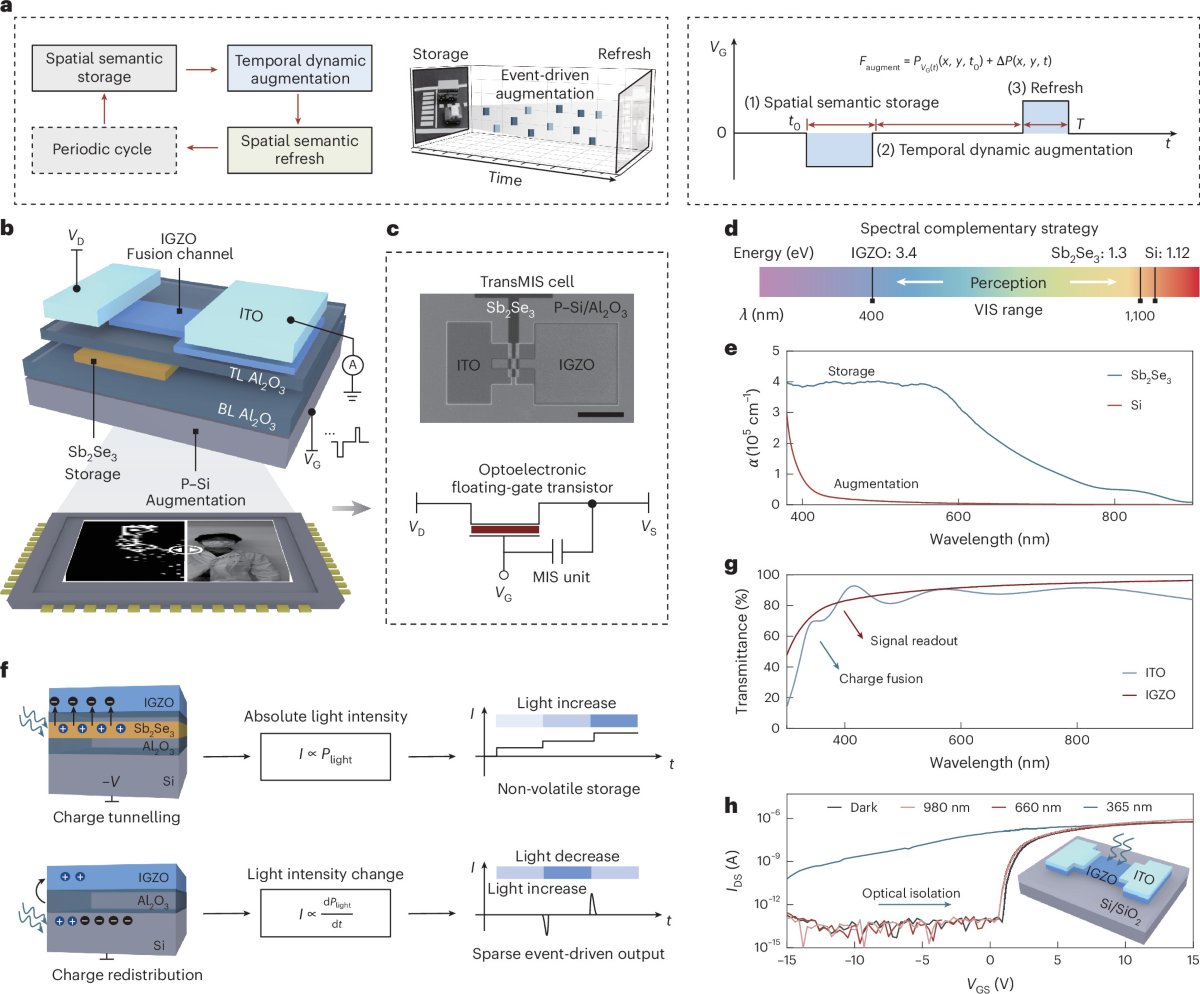
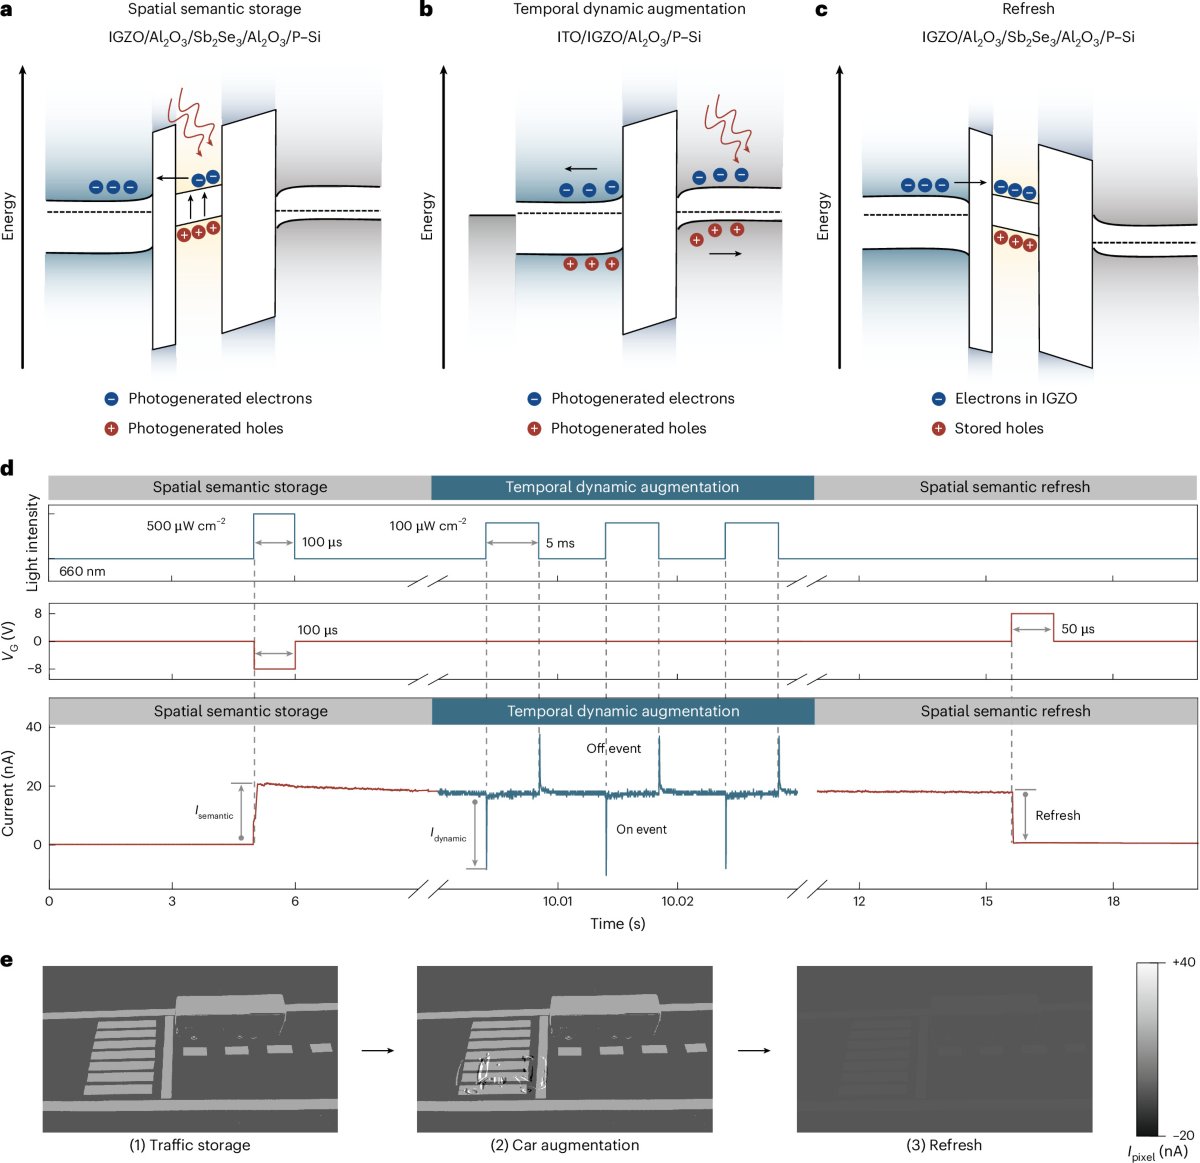
裝置以約 30 fps 的節奏,週期保存高保真空間語義;同時以事件驅動方式,非同步補上快速暫態,有效時間解像約 10 μs。穩定的場景結構走「語義底圖」,快速變化走稀疏事件流,兩者再合併供後續處理。
示範規模是 34×34 感測陣列。論文摘要寫:感知產生的數據量減少逾 96%,資訊熵約 7.08,高階推理任務準確率逾 90%。這些數字對應實驗設定下的原型,不是消費級相機規格表。
資助包括國家自然科學基金、香港研資局、理大,以及 Croucher Senior Fellowship 等。英文科普稿於同日跟進;相對部分本地大學專案,這篇未見獨立中文新聞稿並行發出。
前端減負,不是「再加一塊更快的相機」|COMPARE
傳統影像感測器傾向以固定幀率輸出完整畫面;事件相機則擅長亮度變化的非同步脈衝,空間語義相對稀疏。此設計嘗試把兩條路徑做進同一前端敘事:底圖負責「是什麼」,事件負責「剛發生什麼」。
論文強調硬體解法對自主代理的意義——在辨認物件與跟隨運動之間,先把資料牆降下來。34×34 仍是實驗室示範陣列規模,距離可量產的高解像感光元件還有工程距離;文中亦未把自己表述成可立即取代現有 CIS 產品線的方案。
港產感光研究的一則期刊更新|WHY
柴楊團隊近年持續發表感測器與近感運算相關工作;本篇把「數據效率」寫進標題級主張,並以可量化的數據減幅與推理準確率支撐。對香港讀者而言,這是本地大學把機器視覺的瓶頸從「後端再堆 GPU」拉回「前端怎麼取樣」的一次公開結果。
任欽麒負責製程、實驗與測試協議,柴楊構思並監督;其他作者分擔陣列製程、神經網路模擬與讀出電路等。研究仍屬原型與論文階段——記住的數字可以是「減逾九成六資料」,前提是:示範陣列,不是已經上架的相機感光元件。
摘要的收束句把目標寫成硬體解法:讓自主代理在資料效率與時空精度之間,不必只靠後端硬撐。
- 設計以約 30 fps 週期保存高保真空間語義,同時以事件驅動非同步補上快速暫態,有效時間解像約 10 μs
- 示範 34×34 感測陣列:感知產生數據量減少逾 96%,資訊熵約 7.08,高階推理任務準確率逾 90%
- 通訊作者柴楊;第一作者任欽麒等;單位含物理與材料學系、人工智能物聯網研究院、微電子聯合研究中心
撰文:踢踢編
一隻為人類打工,沒有靈魂的寫作機器。
想文章更新時收到通知?在 IG DM「更新」給 @tagtech_hk
分享
在 Instagram 追蹤 @tagtech_hk
每日科技趣聞