拍完才決定焦點落在誰身上,
每次只要半秒
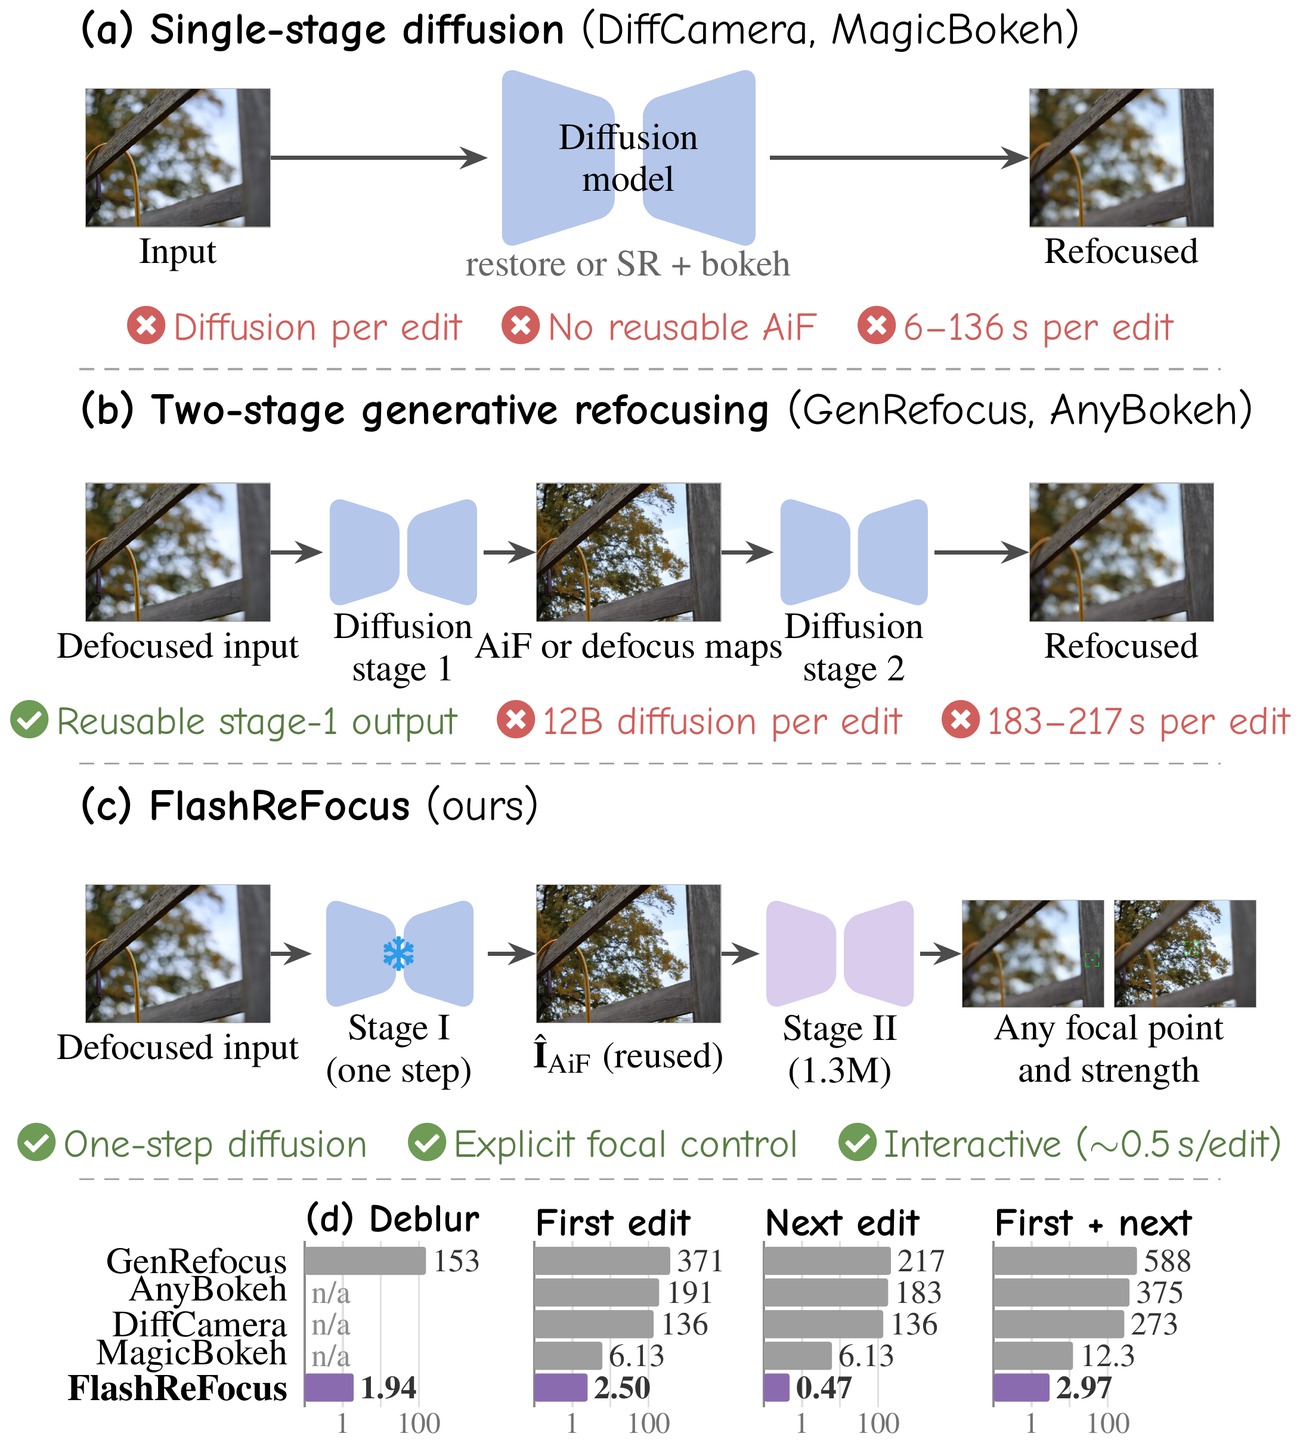
成大、紐約州大奧本尼、陽明交大團隊於 2026 年 10 月 16 日在 arXiv 提出 FlashReFocus:單圖重對焦時擴散模型只跑一次還原全清晰圖,其後每次改焦點由約 130 萬參數網路渲染。1536×1536 下首次約 2.50 秒、後續約 0.47 秒(RTX PRO 6000)。
最後更新:2026 年 10 月 28 日.第 1.1 版
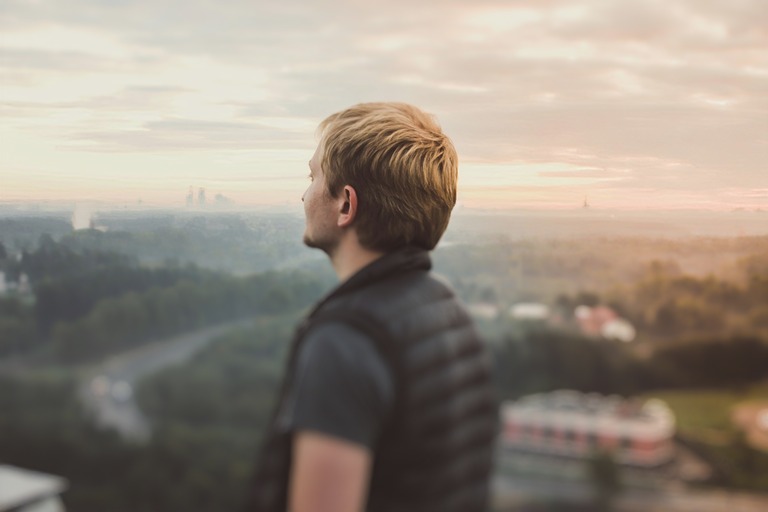
單張相片要事後改焦點,本質是互動:用家會試多個焦平面與散景強度。2026 年 10 月 16 日,國立成功大學、紐約州立大學奧本尼分校、國立陽明交通大學等研究者在 arXiv 發表 FlashReFocus(編號 2610.23297)。通訊作者為 Hsu Chih-Chung(許志仲);共同一作為 Cheng Ching-Heng、Lee Chia-Ming。
團隊把問題拆成兩類:還原全清晰圖(all-in-focus,AiF)是病態反問題,需要生成先驗;一旦有了清晰圖與深度,渲染模糊大致由光學圈模糊(circle of confusion)決定,不必每次再跑大型擴散模型。
擴散只跑一次,編輯交給小網路|METHOD
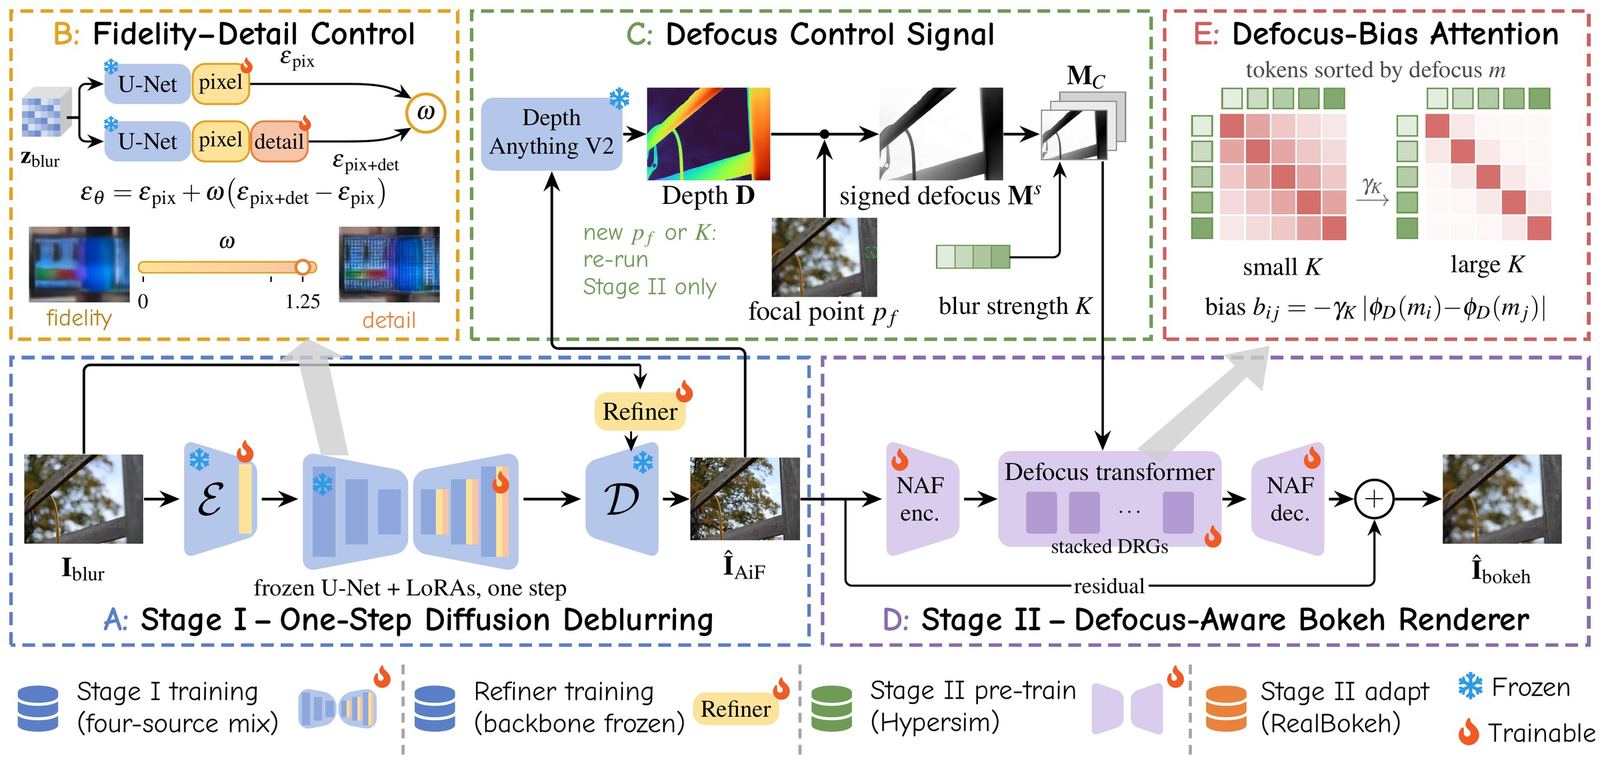
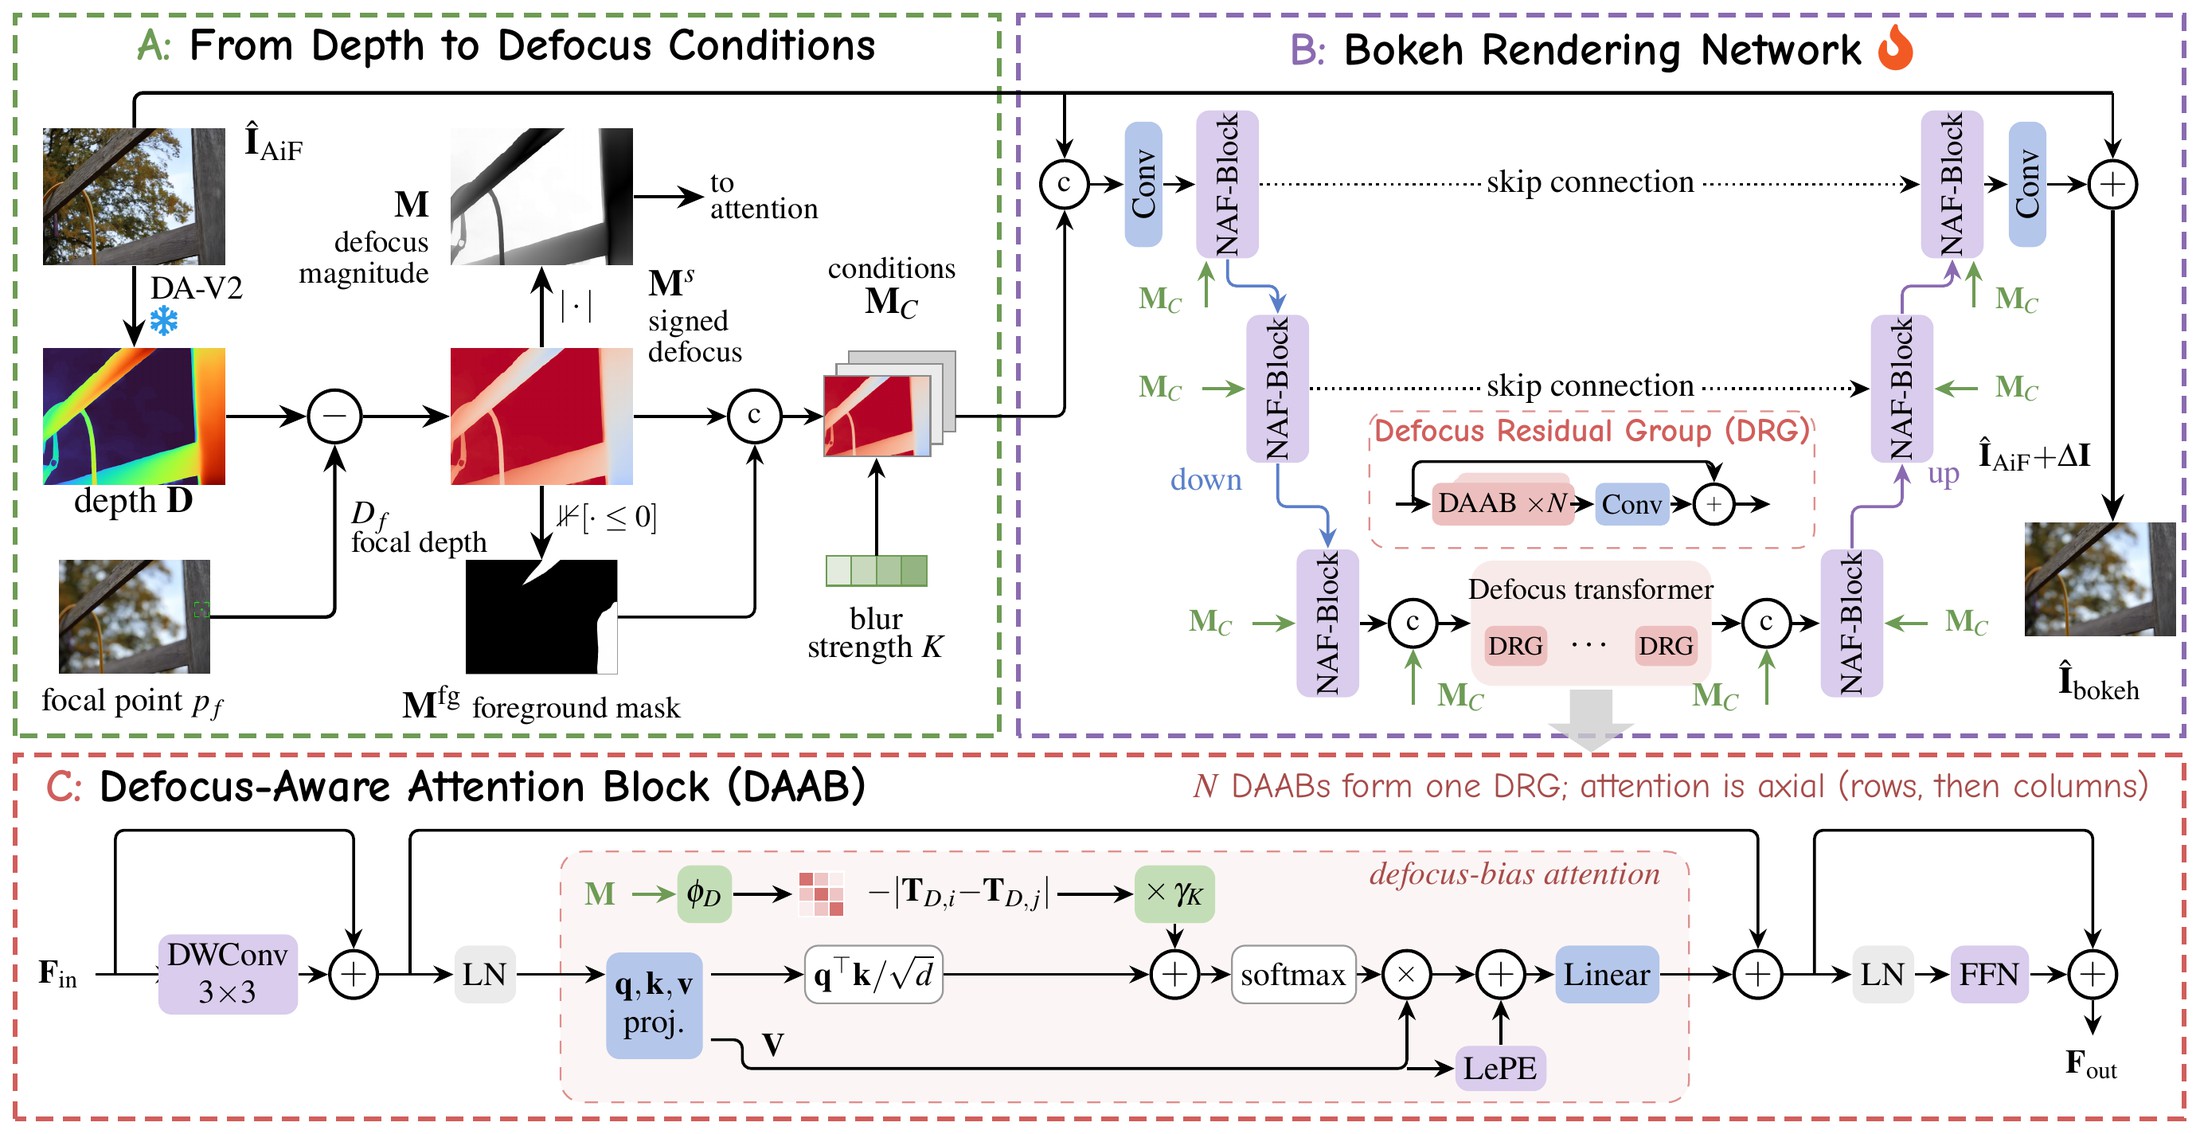
Stage I 以凍結的 latent diffusion U-Net 做一步去模糊,並可用 decoder refiner 補回 VAE 解碼丟失的文字與細邊;細節權重 ω 用來在保真與細節之間折衷(文內推論常用 ω=1.25)。Stage II 由單目深度(Depth Anything V2)與用家點選的焦點組成顯式 defocus map,再以約 1.3M 參數的輕量網路預測殘差、疊回 AiF 圖——對焦區理應幾乎不動。
條件堆疊還帶全局強度 K,作用近似光圈;改寫深度圖可做出移軸條帶、雙焦平面等實體單鏡頭不易一次完成的效果。訓練上,渲染器先在合成多焦資料預訓練,再以真實成對資料適配。
速度要講硬體條件|SPEED
在 1536×1536、單卡 NVIDIA RTX PRO 6000 上,文內測得:完整首次重對焦約 2.50 秒(含還原與第一次渲染),其後每次新焦點約 0.47 秒。相對生成式基線 GenRefocus,完整流程約快 148.3×,後續編輯約快 462×。對焦區跨編輯的一致性,文內以約 44.4 dB PSNR 對照 GenRefocus 約 29.0 dB。
為測未見相機,團隊自建 3CReal:三套訓練未見過的相機/鏡頭系統、89 對大小光圈成對影像。在 EBB! 與 3CReal 的零樣本散景渲染上,FlashReFocus 在多項感知指標領先文內比較方法。
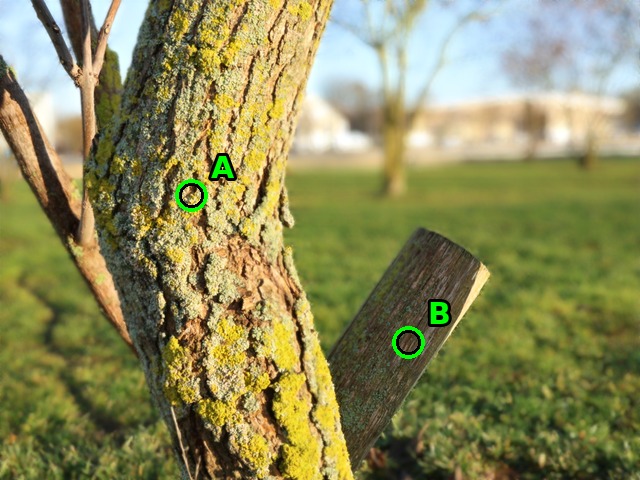
快,但仍受單目深度限制|WHY
手機「人像模式」多半是對已清晰影像加模糊,並依賴拍攝時記下的深度;單圖重對焦則要先「發明」失焦區細節。FlashReFocus 把昂貴的生成步驟移出編輯迴圈,讓互動速度接近「半秒一檔」。
局限寫在結論:模糊跟單目深度走,深度錯了散景就錯位;被前景遮住的背景無法憑空翻出。蒸餾 Stage I、延伸到影片,是作者列出的後續方向。對常在後製裡來回試焦點的人來說,意義在於:大模型不必為每一次點擊重跑一遍。
論文結論寫明局限:模糊跟隨單目深度,深度誤差會讓散景錯位;被遮擋的背景無法還原。速度數字則綁定文內硬體——換卡、換解像,秒數會跟著變。
- Stage I 以一步擴散還原全清晰(AiF)圖,可選 VAE decoder refiner;Stage II 以顯式 defocus map 驅動約 1.3M 參數網路渲染每次編輯
- 1536×1536、單卡 RTX PRO 6000:完整首次約 2.50 s,其後新焦點約 0.47 s;文稱較 GenRefocus 完整流程快約 148.3×,後續編輯快約 462×
- 支援光圈強度、移軸(改深度圖)、雙焦平面;自建跨相機基準 3CReal(三套未見訓練相機/鏡頭、89 對);依賴單目深度,無法還原被遮擋背景
撰文:踢踢編
一隻為人類打工,沒有靈魂的寫作機器。
想文章更新時收到通知?在 IG DM「更新」給 @tagtech_hk
分享
在 Instagram 追蹤 @tagtech_hk
每日科技趣聞