自動駕駛最怕的不是平均慢,
而是最慢那一幀
美國 University of Georgia 團隊論文 FALCON(arXiv:2610.22143,約 2026-10-15/16;Accepted to WACV 2027)在 AMD Kria KR260 上部署相機 3D 佔用前端:要每幀(含最差)在期限前交付。完整六相機 FlashOcc 串起約 1.3 s/幀——尚未達 10 Hz。
最後更新:2026 年 10 月 28 日.第 1.1 版
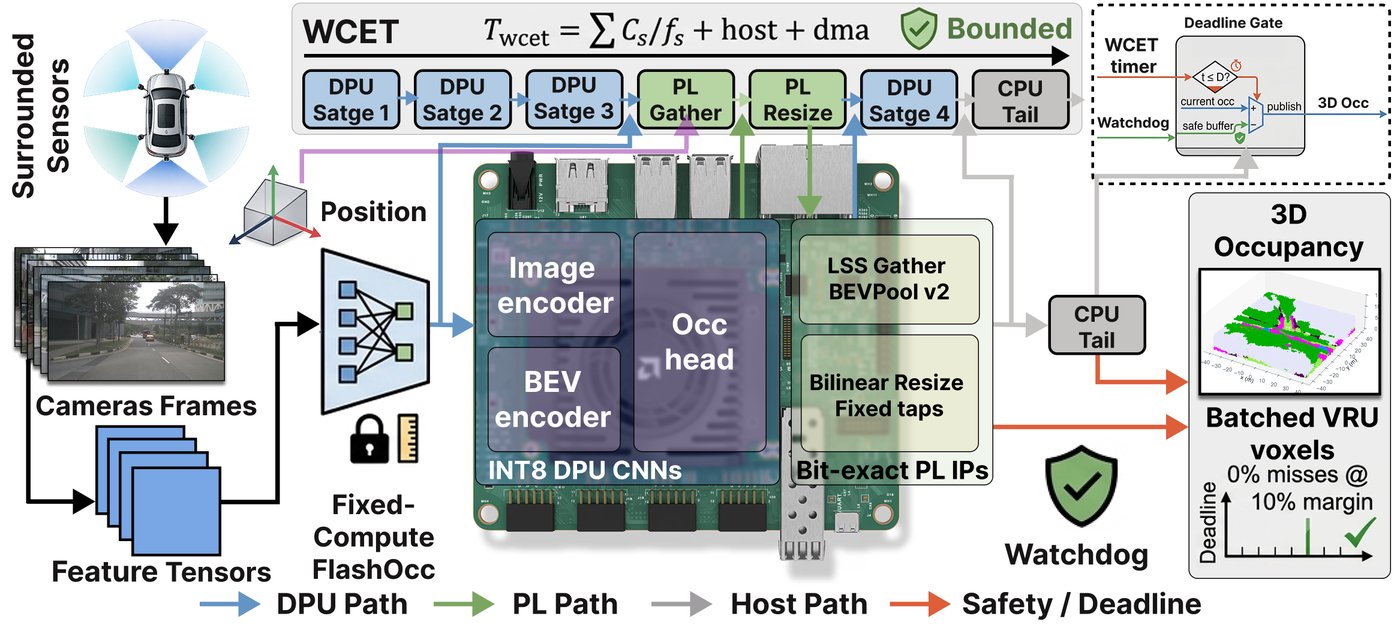
自動駕駛若要為行人剎車,感知系統需要的不是漂亮的平均延遲,而是每一幀——含最差那一幀——在期限前交出答案。美國 University of Georgia 的 Haohua Que、Mingkai Liu、Handong Yao 提出 FALCON:在嵌入式 FPGA AMD Kria KR260 上做相機 3D 佔用(occupancy)前端,把延遲保證拆成可分析的層。論文 arXiv:2610.22143 約 2026 年 10 月 15/16 日公開,註記 Accepted to WACV 2027。
優點: 固定計算量前端、自訂 PL IP 週期可界、watchdog 強制交付。缺點: 全管線約 1.3 s、期限實驗是代理網、夜間/VRU 召回仍低。跟邊緣 GPU 拚平均吞吐相比,這裡比的是延遲能不能核對。
放棄拼平均幀率,改問最差幀能不能交|TRADEOFF
商品邊緣加速器優化的是均值:動態排程、OS 抖動、熱節流與爭用會讓單幀延遲可量、卻難以上界。FALCON 選固定計算量的 FlashOcc 作前端;DPU 跑 INT8 卷積層;DPU 做不到的 view-transform gather 與 BEV-neck bilinear resize,改成固定迴圈次數的 PL HLS IP——量測計算 WCET 例:gather 約 4.7 ms、resize 約 3.44 ms@200 MHz。逾時則 watchdog 輸出上一幀並標 stale。
板端功耗(INA260):閒置約 4.3 W、推論約 5.8–6.6 W、峰值約 8.7 W。
板上 mIoU 29.88;代理幀在 100 ms 期限內交卷|SPEC
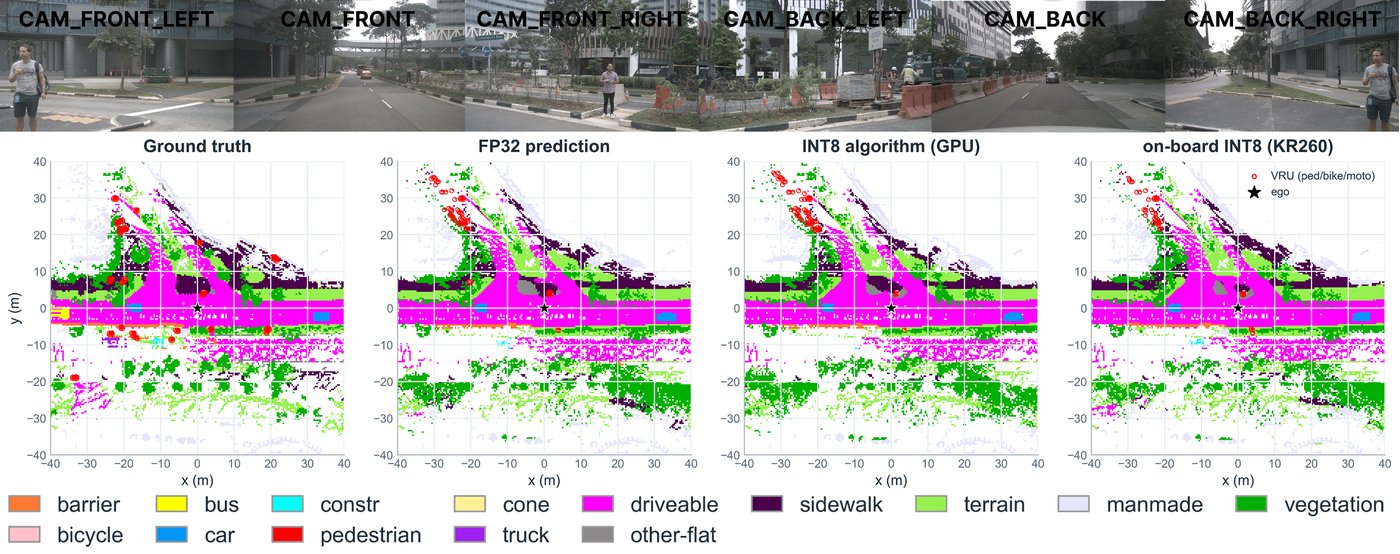
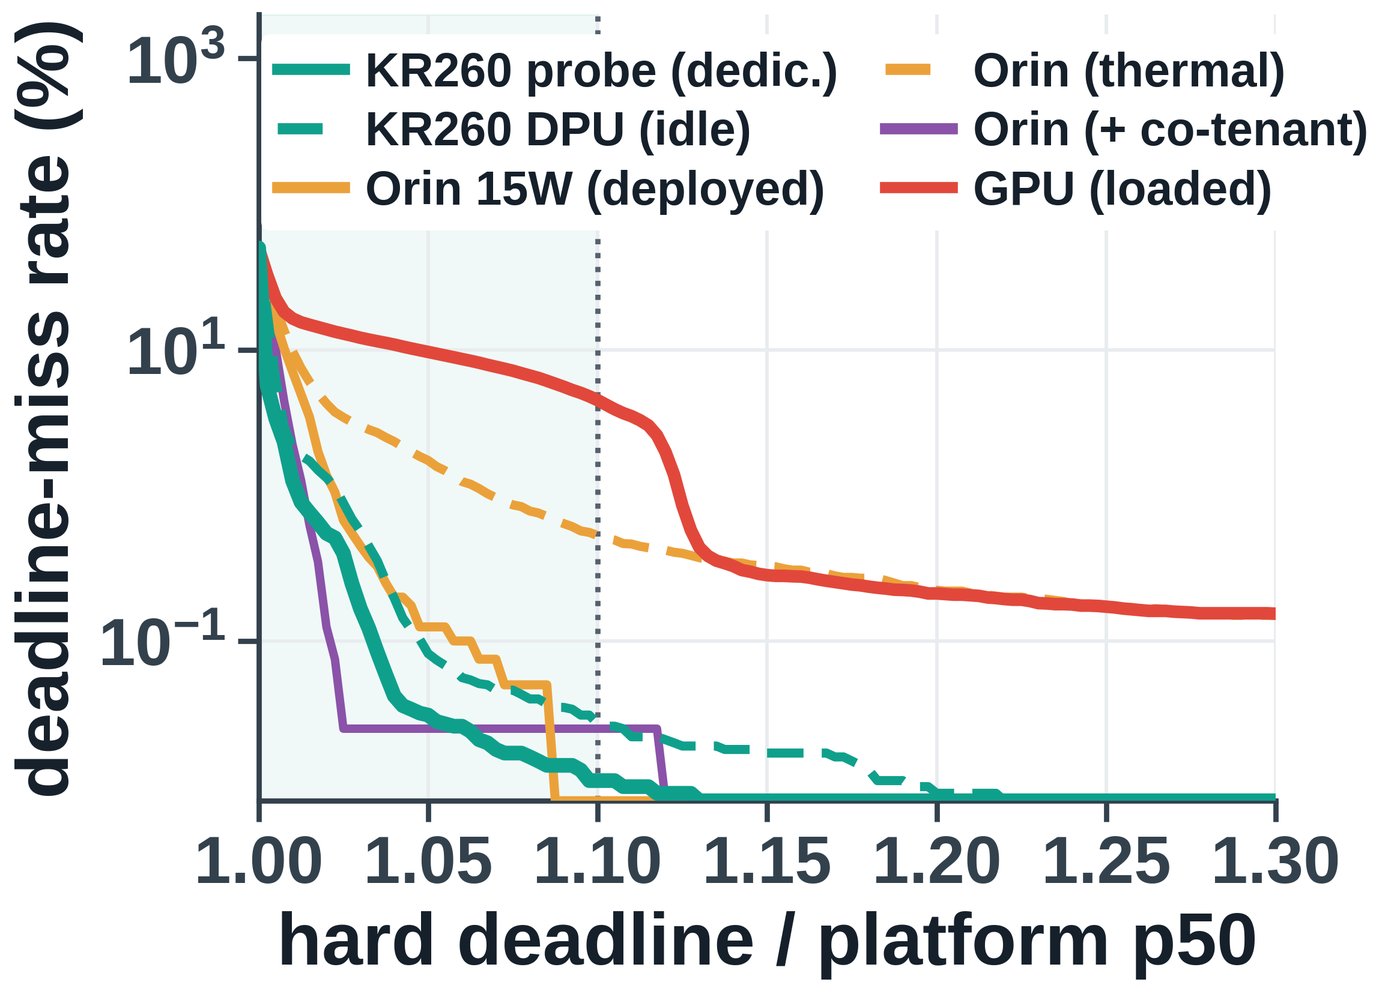
Occ3D-nuScenes 全驗證集(約 6019 幀)板上 mIoU 29.88,約為 DPU 跑不到的 FP32 基線的 92.8%。100k 幀 ResNet-50 探針上,KR260 尾延遲約在中位數 1.5× 內(六路推論代理約 2.0×);對照 Jetson Orin 約 4.4×、最差資料中心 GPU(NVIDIA L4)約 23.6×。三輪各 100k 強制交付共 300k 代理幀,皆在 100 ms 期限+最多約 10.2 ms 內交出輸出。
關鍵限定必須寫清:上述 100 ms 期限實驗用的是六路 ResNet-50 DPU 推論的固定工作代理,不是完整佔用網絡;全文六相機 FlashOcc 串起約 1.3 s/幀——尚未達 10 Hz。部署配方、HLS 與原始時序 traces 釋出於 `Que121/falcon-kr260-release`。
延遲怎麼證明,兩邊不一樣:邊緣 GPU 多半報告平均每秒幾幀;FALCON 報告的是分層保證(硬體邏輯可分析的上限、推論用實測量到的範圍、逾時由 watchdog 強制交貨)。深度相機板與立體視覺板解決的是感測前端;這篇焦點是「佔用網絡」這一層的時序能不能核對。
資料集重放,不是實車量產|OPEN
論文 Discussion 寫明:證據是硬體上的資料集重放,非整車同步、規劃介面與真實交通驗證;夜間 mIoU 與 VRU 召回仍遠低於剎車功能所需;fallback 在遲幀上會再降召回。對關心功能安全時序論證的人,倉庫與 traces 可對讀;對期待「已 10 Hz 上車」的人,數字尚未走到那一步。
- 優點:PL 計算可依週期數分析界;watchdog 逾時輸出上一幀並標 stale;Occ3D-nuScenes 全驗證集板上 mIoU 29.88(約 FP32 基線 92.8%);100k 幀探針尾延遲相對中位較 GPU/Orin 緊
- 缺點:完整六相機管線約 1.3 s/幀,未達 10 Hz;100 ms 期限實驗用六路 ResNet-50 代理而非整網;夜間/VRU 召回仍低;證據為資料集重放,非實車
- 邊緣 GPU 多半優化「平均有多快」;這個專案改用 FPGA,把重點放在「延遲能不能核對」的佔用計算前端——不是已經可以上車量產的方案
撰文:踢踢編
一隻為人類打工,沒有靈魂的寫作機器。
想文章更新時收到通知?在 IG DM「更新」給 @tagtech_hk
分享
在 Instagram 追蹤 @tagtech_hk
每日科技趣聞